
LLM İçin GPU Rehberi
LangChain ile uygulama geliştiriyorsunuz, lokalde model koşturuyorsunuz, RAG kuruyorsunuz. Sonra sohbet H100’e, 4090’a, “şu kart kaç GB” muhabbetine geliyor ve kafanız duruyor. Bu yazıda bir GPU’nun içinde ne olduğunu, kart isimlerinin neyi kodladığını ve “bu model bu karta sığar mı” sorusunu kâğıt üstünde cevaplamayı birlikte öğreneceğiz. Şunu baştan söyleyelim: bu kafa karışıklığı sizin eksiğiniz değil. […]
vLLM EC2 + Rocky Linux Kurulum
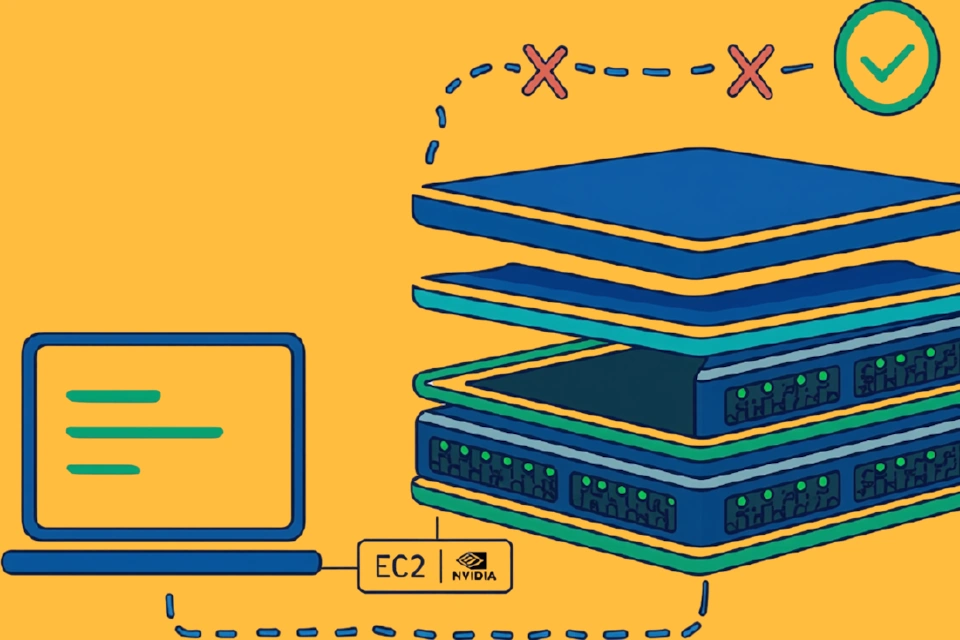
Serinin ilk iki [1- 4 GB’lık Laptop Ekran Kartında vLLM ve 2- RunPod’da GPU Kiralayıp vLLM Koşturma yazısında hep birinin bizim için hazırladığı ortamlarda çalıştık — driver’a hiç dokunmadık, dokunamadık da. Bu final yazısında o perdeyi kaldırıyoruz: AWS’de çıplak bir Rocky Linux makinesi açacağız ve kernel modülünden vLLM sunucusuna kadar her katmanı kendi ellerimizle kuracağız. […]
LLM Fine-Tuning
“Biz de modeli fine-tune edelim” Gerçekten buna ihtiyacınız var mı? Varsa seçenekleriniz neler? Bu yazıda LoRA’dan QLoRA’ya, DPO’dan GRPO’ya yöntemlerin üzerinden geçeceğiz; ne zaman fine-tune etmek gerektiğini, ne zaman gerekmediğini ve birkaç dolarlık bir GPU kirasıyla neler yapılabileceğine bakacağız. Bu yazıya “fine-tuning’in ne olduğunu duydum ama kafamda oturmadı” diyerek geldiyseniz tam yerindesiniz. Yazının sonunda, eğer […]
RunPod’da GPU Kiralayıp vLLM Koşturma
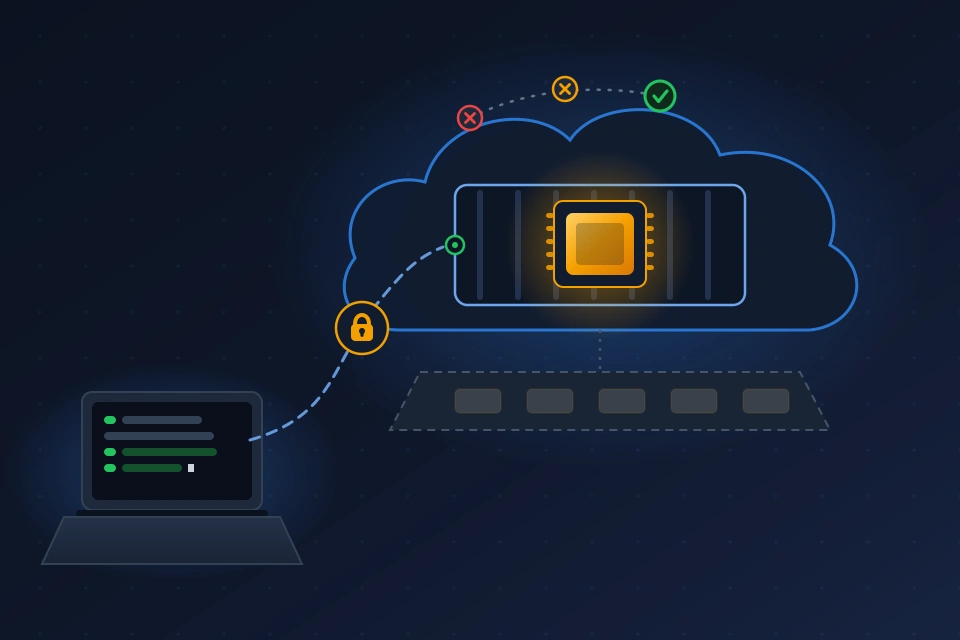
GPU satın almak zor ve pahalı, laptop GPU’larının kapasitesi sınırlı. Adamakıllı bir model koşturmak istiyorsunuz ancak çok para harcamak istemiyorsunuz. O zaman GPU kiralamak mantıklı bir seçenek oluyor. Peki kiraladınız bu sefer driver kurulumu yükleme vs. kim uğraşacak? Siz mi yoksa bunlar da hazır gelsin ben sadece kullanayım mı? O halde doğru adres runpod olabilir. […]
4 GB’lık Laptop Ekran Kartında vLLM

GPU kiralamadan önce elimdeki donanıma baktım: WSL2 içinde Oracle Linux, 4 GB VRAM’li bir RTX A2000 Laptop. “Bir akşamda kurarım” dedim. Kurdum kurmasına — ama araya bir başarısız kurulum ve beş başarısız çalıştırma girdi; altı ayrı neden, her biri bir öncekinin arkasından çıktı. Bu yazıda hem vLLM’i küçük kartta ayağa kaldırmayı hem de o altı […]
vLLM: Bir GPU’dan Yüzlerce Kullanıcıyı Beslemek

Ollama ile modelinizi ayağa kaldırdınız, harika çalışıyor. Sonra ekipten on kişi aynı anda bağlandı ve her şey tıkandı. Bu yazıda tam olarak bunun neden olduğunu, vLLM’in hangi numaralarla aynı ekran kartından 20 kat fazla iş çıkardığını ve alternatiflerinin ne zaman daha doğru tercih olduğunu birlikte öğreneceğiz. Bu yazıya “LLM nedir biliyorum, hatta lokalde model çalıştırdım […]
Bloom Filter Nedir? Arrow’un Yeni Çözümü: Bloom Filter Folding

Bir bloom filter’ı ne kadar büyük yapacağınıza karar vermek için kaç farklı değer geleceğini bilmeniz gerekir. Ama yazmaya başlarken bunu bilmezsiniz. Arrow’un yeni çözümü şu: önce bol bol yer ayır, sonra katla. Başlığa bakıp “tamam da bloom filter neydi?” diyorsanız, iki cümlede halledelim: bloom filter, tek bir soruya cevap veren minik bir veri yapısıdır — […]
Bir Spark Job’ının Perde Arkası: Veri Nereden Okunur, Shuffle’da Ne Olur, Driver Ne İş Yapar?

groupBy yazmak üç saniye sürüyor; peki o üç saniyelik satır cluster’da neleri harekete geçiriyor? Gelin perdeyi birlikte aralayalım. Apache Spark ile çalışan çoğumuz için hikâye şöyle başlar: Bir DataFrame okuruz, birkaç dönüşüm (transformation) zincirleriz, sonuca bakarız. Kod çalışır, iş biter. Ama işler yavaşlamaya başladığında — ki büyük veride er ya da geç başlar — perdenin […]