
Jev: Konuşmayan, Karar Veren Yapay Zekâ
Bugün son günlerin en çok konuşulan modellerinden birini, Jev‘i ele alacağız. Ne olduğunu, nasıl çalıştığını ve neden bizim için önemli olduğunu birlikte göreceğiz. Önce bir soru: Otomasyon nerede kaldı? 2022’de ChatGPT çıktığından beri modeller hep aynı yöne gelişti: insanlarla daha iyi sohbet etmek. Sonra kodlama ajanları (coding agents) geldi, modeller bu iş için de eğitildi. […]
LLM Quantization Nedir?
Llama 3.1 70B’nin ağırlıkları 140 GB; elinizdeki en iyi oyun kartında 24 GB var. Buna rağmen insanlar bu modeli evde çalıştırıyor. Bu yazıda quantization’ın ne olduğunu dört sayıyı elle yuvarlayarak göreceğiz, “4-bit” kelimesinin arkasındaki üç ayrı kararı ayıracağız ve modeli küçültürken neyi kaybettiğimizi ölçümlerle konuşacağız. ChatGPT’ye ya da Claude’a soru yazdığınızda cevap bir sohbet kutusundan […]
Agent Harness ve Harness Engineering Nedir?
Prompt engineering’i öğrendik, context engineering’e alıştık; şimdi herkes “harness” diyor. Terim hem çok geniş hem çok spesifik olduğu için kafa karıştırıyor. Gelin bu yazıda harness’ın ne olduğunu, ne olmadığını ve neden 2026’da bu kadar konuşulduğunu, OpenAI ve Anthropic’in kendi anlattıklarıyla birlikte öğrenelim. “Harness, ajanın (agent) çalıştığı ortamdır” cümlesini muhtemelen duydunuz. Doğru ama eksik; çünkü “ortam” […]
Mixture of Experts Nedir?
DeepSeek-V3’ün 671 milyar parametresi var ama ürettiği her token için bunların sadece 37 milyarını çalıştırıyor. Kulağa hile gibi geliyor; değil. Bu yazıda Mixture of Experts mimarisini adım adım kuracağız — router’ın kararını elle hesaplayacağız, “8x7B neden 56 milyar etmiyor” sorusunu cevaplayacağız ve bu tasarımın hangi faturayı ödeyerek bu tasarrufu yaptığını göreceğiz. Klasik bir dil modelinde […]
LLM İçin GPU Rehberi
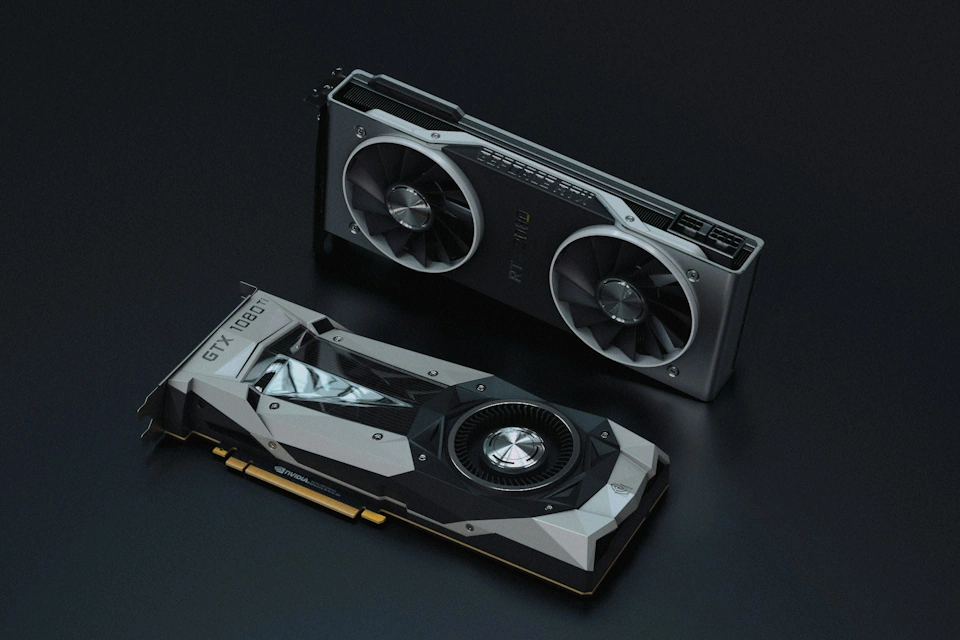
LangChain ile uygulama geliştiriyorsunuz, lokalde model koşturuyorsunuz, RAG kuruyorsunuz. Sonra sohbet H100’e, 4090’a, “şu kart kaç GB” muhabbetine geliyor ve kafanız duruyor. Bu yazıda bir GPU’nun içinde ne olduğunu, kart isimlerinin neyi kodladığını ve “bu model bu karta sığar mı” sorusunu kâğıt üstünde cevaplamayı birlikte öğreneceğiz. Şunu baştan söyleyelim: bu kafa karışıklığı sizin eksiğiniz değil. […]
vLLM EC2 + Rocky Linux Kurulum
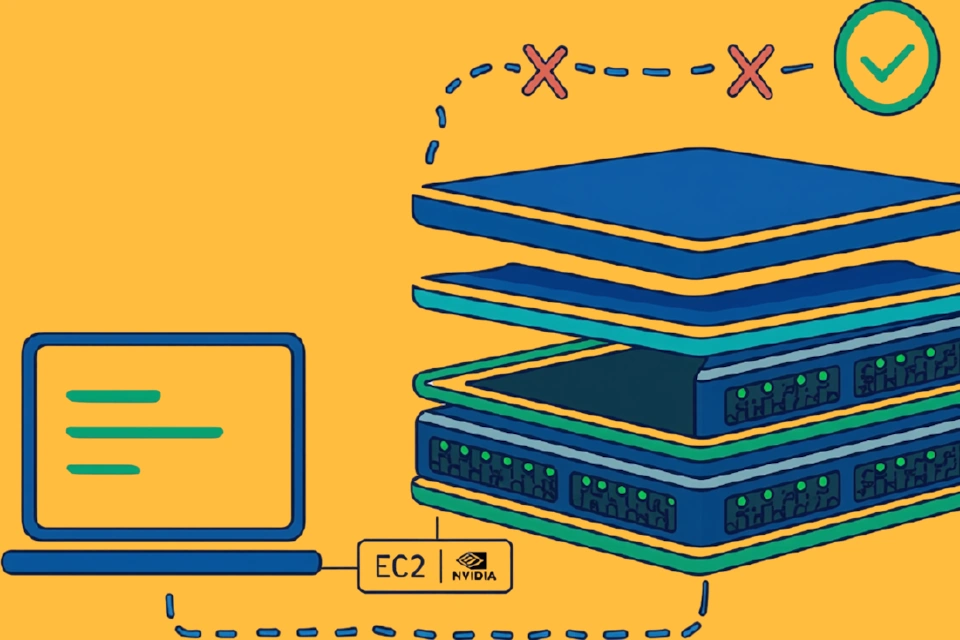
Serinin ilk iki [1- 4 GB’lık Laptop Ekran Kartında vLLM ve 2- RunPod’da GPU Kiralayıp vLLM Koşturma yazısında hep birinin bizim için hazırladığı ortamlarda çalıştık — driver’a hiç dokunmadık, dokunamadık da. Bu final yazısında o perdeyi kaldırıyoruz: AWS’de çıplak bir Rocky Linux makinesi açacağız ve kernel modülünden vLLM sunucusuna kadar her katmanı kendi ellerimizle kuracağız. […]
LLM Fine-Tuning
“Biz de modeli fine-tune edelim” Gerçekten buna ihtiyacınız var mı? Varsa seçenekleriniz neler? Bu yazıda LoRA’dan QLoRA’ya, DPO’dan GRPO’ya yöntemlerin üzerinden geçeceğiz; ne zaman fine-tune etmek gerektiğini, ne zaman gerekmediğini ve birkaç dolarlık bir GPU kirasıyla neler yapılabileceğine bakacağız. Bu yazıya “fine-tuning’in ne olduğunu duydum ama kafamda oturmadı” diyerek geldiyseniz tam yerindesiniz. Yazının sonunda, eğer […]
RunPod’da GPU Kiralayıp vLLM Koşturma
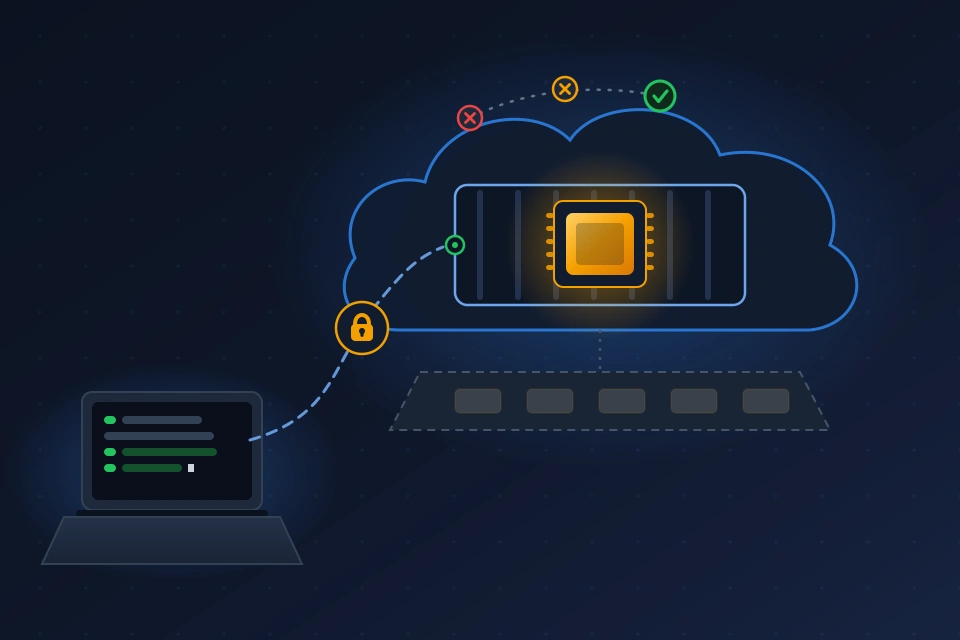
GPU satın almak zor ve pahalı, laptop GPU’larının kapasitesi sınırlı. Adamakıllı bir model koşturmak istiyorsunuz ancak çok para harcamak istemiyorsunuz. O zaman GPU kiralamak mantıklı bir seçenek oluyor. Peki kiraladınız bu sefer driver kurulumu yükleme vs. kim uğraşacak? Siz mi yoksa bunlar da hazır gelsin ben sadece kullanayım mı? O halde doğru adres runpod olabilir. […]
4 GB’lık Laptop Ekran Kartında vLLM

GPU kiralamadan önce elimdeki donanıma baktım: WSL2 içinde Oracle Linux, 4 GB VRAM’li bir RTX A2000 Laptop. “Bir akşamda kurarım” dedim. Kurdum kurmasına — ama araya bir başarısız kurulum ve beş başarısız çalıştırma girdi; altı ayrı neden, her biri bir öncekinin arkasından çıktı. Bu yazıda hem vLLM’i küçük kartta ayağa kaldırmayı hem de o altı […]
vLLM: Bir GPU’dan Yüzlerce Kullanıcıyı Beslemek

Ollama ile modelinizi ayağa kaldırdınız, harika çalışıyor. Sonra ekipten on kişi aynı anda bağlandı ve her şey tıkandı. Bu yazıda tam olarak bunun neden olduğunu, vLLM’in hangi numaralarla aynı ekran kartından 20 kat fazla iş çıkardığını ve alternatiflerinin ne zaman daha doğru tercih olduğunu birlikte öğreneceğiz. Bu yazıya “LLM nedir biliyorum, hatta lokalde model çalıştırdım […]
Bloom Filter Nedir? Arrow’un Yeni Çözümü: Bloom Filter Folding

Bir bloom filter’ı ne kadar büyük yapacağınıza karar vermek için kaç farklı değer geleceğini bilmeniz gerekir. Ama yazmaya başlarken bunu bilmezsiniz. Arrow’un yeni çözümü şu: önce bol bol yer ayır, sonra katla. Başlığa bakıp “tamam da bloom filter neydi?” diyorsanız, iki cümlede halledelim: bloom filter, tek bir soruya cevap veren minik bir veri yapısıdır — […]
Bir Spark Job’ının Perde Arkası: Veri Nereden Okunur, Shuffle’da Ne Olur, Driver Ne İş Yapar?

groupBy yazmak üç saniye sürüyor; peki o üç saniyelik satır cluster’da neleri harekete geçiriyor? Gelin perdeyi birlikte aralayalım. Apache Spark ile çalışan çoğumuz için hikâye şöyle başlar: Bir DataFrame okuruz, birkaç dönüşüm (transformation) zincirleriz, sonuca bakarız. Kod çalışır, iş biter. Ama işler yavaşlamaya başladığında — ki büyük veride er ya da geç başlar — perdenin […]
Kafka listeners ve advertised.listeners
Bu kafka listeners ve advertised listeners gerçekten gıcık bir konu. Kafka’ya bağlanamayığ saç baş yoldurabiliyor bazen. Şimdiye dek Kafka konfigürasyonunda listeners ve advertised.listeners‘ı en az bir kez Google’da aratmış olabilirsin ama artık yapay zekalara soruyorsunuzdur muhtemelen YZ da bu işi çözüyordur ve tıkır tıkır Kafka’ya bağlanıyorsunuzdur. peki YZ’nin çözdüğünü siz çözdünüz mü? Çözemediyseniz bu iki […]
16 Çeşit RAG ve LangChain ile Hangilerini Hayata Geçirebiliriz?
Selam! Bugün biraz heyecanlı bir konuya giriyoruz. RAG (Retrieval-Augmented Generation) dünyası son bir yılda öyle bir patladı ki, klasik “vektör veritabanından chunk çek, LLM’e ver” mantığı çoktan ilkokul seviyesinde kaldı. Turing Post’un derlediği listede karşımıza çıkan 16 farklı yeni RAG çeşidini[1] tek tek inceleyeceğiz, sonra da “Peki ben bunları LangGraph ya da LangChain ile yapabilir […]
Veri Ambarı Star Şemada Bridge Table
Veri ambarı (data warehouse) modellemesinde bir gün mutlaka şu sorunla karşılaşırız: tek bir fact satırı, birden fazla boyut değerine bağlanmak istiyor. Bir hasta ziyaretinin birden çok tanısı vardır, bir banka hesabının birden çok ortak sahibi olabilir, bir öğrenci birden çok ana dalda okuyabilir, bir makaleyi birden çok yazar yazabilir. Klasik yıldız şeması (star schema) ise […]
Pandas DataFrame’lerini SQL ile Sorgulamak: DuckDB, query() ve Ötesi
Önceki yazımızda pandas’ın veritabanlarıyla nasıl konuştuğunu (ADBC sürücüleri) gördük. Peki ya tersi? Elimizde zaten bir DataFrame var ve onu doğrudan SQL ile sorgulamak istiyoruz — filtreleme (filtering), dönüştürme (transformation), toplulaştırma (aggregation), birleştirme (join). Bu mümkün mü? Hem de fazlasıyla. Bu yazıda pandas sql kullanımı konusunda mevcut yolları öğreneceğiz, hangisinin hangi durumda en iyi olduğunu göreceğiz […]
Pandas SQL: ADBC (Arrow Database Connectivity)
Eğer veri analizinde pandas ile SQL veritabanları arasında köprü kuran biriyseniz, muhtemelen pd.read_sql() ve df.to_sql() çağrılarınızın kaplumbağa hızında çalıştığı, hatta veri tiplerinin (data types) yolda kaybolduğu anlar yaşamışsınızdır. İyi haber: pandas 2.2 ile birlikte gelen ADBC (Arrow Database Connectivity) sürücü desteği, bu hikayeyi tamamen değiştiriyor [1][2]. Bu yazıda yeni özelliği baştan sona inceleyeceğiz, neden bu […]
Apache Spark’ı Kubernetes Üzerinde Çalıştırmak: Sıfırdan Canlı Ortama Tam Rehber
Eğer büyük veri (big data) dünyasının içindeysek, Apache Spark’ın adını mutlaka duymuşuzdur. Yıllardır YARN üzerinde, standalone modda veya Mesos ile çalıştırdığımız bu güçlü dağıtık hesaplama motorunu (distributed computing engine) artık Kubernetes üzerinde, hem de “native” yani yerel olarak çalıştırabiliyoruz. Spark 2.3 ile başlayan bu yolculuk, 2026 yılında Spark 4.1’e ve Apache vakfının resmi Spark Kubernetes […]
DeepAgent Nedir?
Son iki yılda yapay zeka dünyasında en çok konuşulan konulardan biri “ajan” (agent) mimarileri oldu. Claude Code, Deep Research, Manus gibi uygulamalar, büyük dil modellerinin (Large Language Models – LLM) artık sadece soru cevaplayan değil, planlayan, araştıran, kod yazan, dosya oluşturan, hatta kendi içinde başka alt ajanları çalıştırabilen sistemler haline geldiğini bize gösterdi [1][2]. İşte […]
MCP ve LangChain ile Randevu Asistanı Oluşturmak
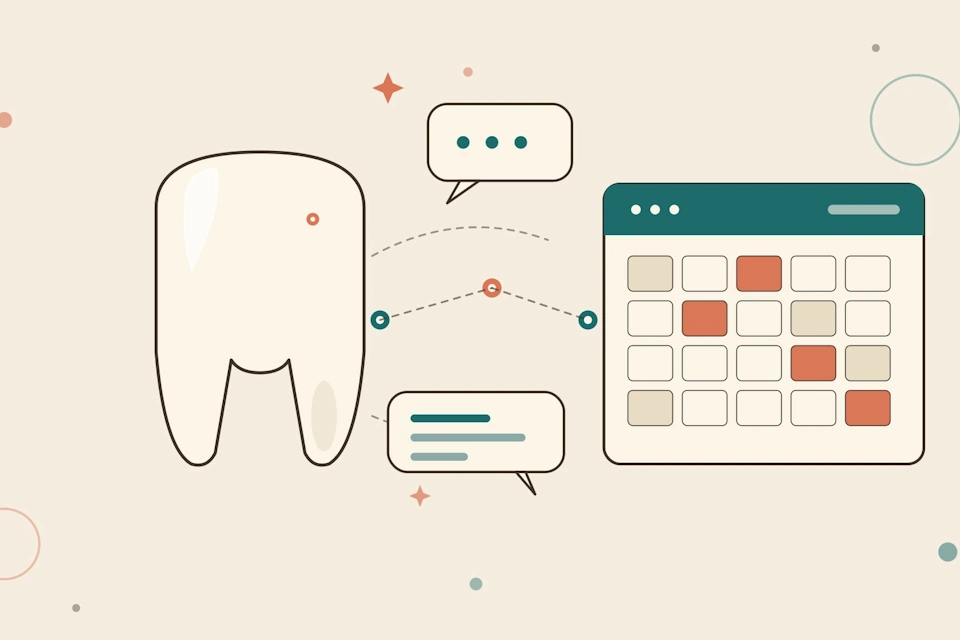
Diş kliniğinin resepsiyonunda çalıştığınızı hayal edin. Telefon çalıyor, hasta randevu istiyor. Siz ajandayı açıyor, boş slotu buluyor, hastanın adını yazıyor, e-posta gönderiyorsunuz. Gün içinde bunu 30-40 kez tekrar ediyorsunuz. Peki bütün bunları doğal dilde — “Fatma Hanım’a cuma 14:00’e temizlik için randevu ver” der gibi — konuşarak yapabilseydik? Hem de Google Takvim (Google Calendar) ile […]